分析师为一家上市公司搭建三表、完成 DCF 和可比公司分析,通常需要数天。官方金融财务建模智能体将取数、规范化、预测、估值和质检整合为标准流程,一次完整建模约需 45–90 分钟,即可生成可编辑的 Excel 模型。实际耗时取决于标的数据量和材料数量。
输入股票代码(ticker)或上传财务数据即可开始建模,生成公式可追踪、图表引用计算单元格的 Excel 工作簿。所有假设集中记录在 Assumptions 工作表中,修改假设后,全模型可联动重算。智能体仅用于财务建模,不执行交易,也不提供投资建议。
Agent 架构总览
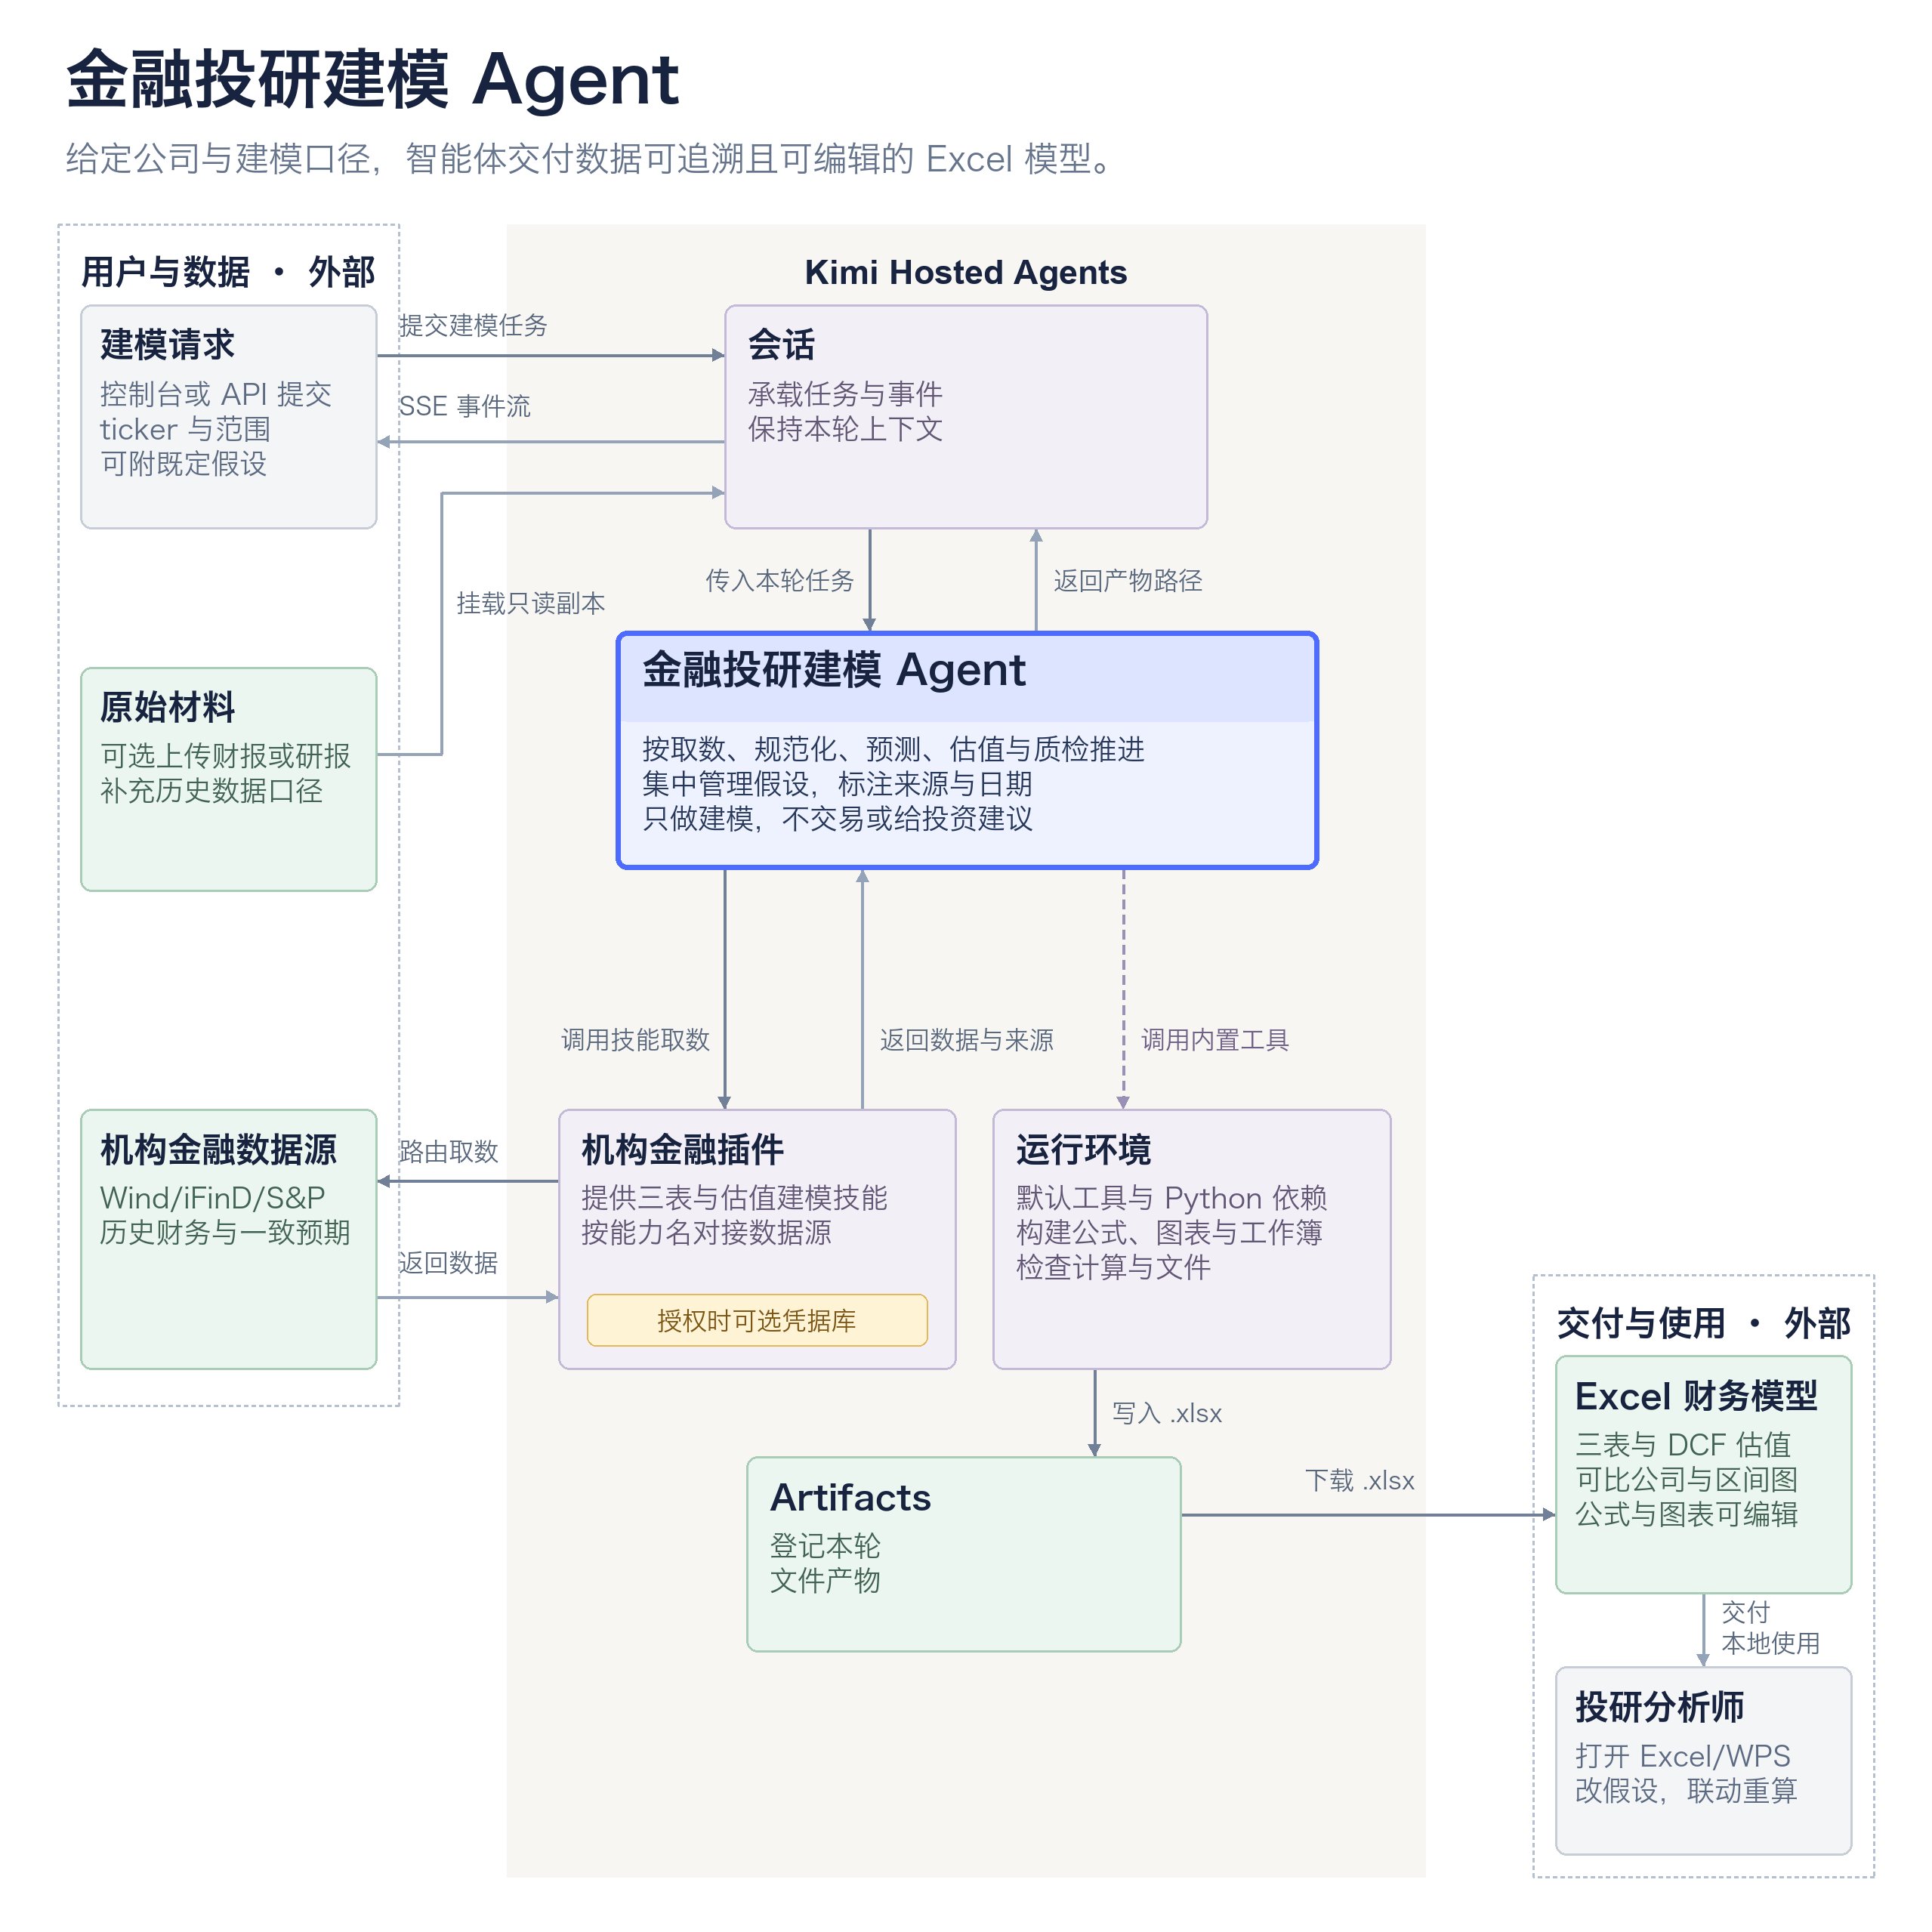
一次建模任务的数据流如下:
调用方创建会话并提交任务,明确标的代码、模型范围和已有假设;如有财报原文,可先上传并挂载;
智能体通过机构金融插件的数据源路由获取历史财务、市场一致预期和可比公司行情等数据,并为每个关键输入标注来源和取数日期;
数据齐备后开始构建模型,依次完成报表规范化、盈利预测和估值建模,并将全部假设集中写入 Assumptions 工作表;
在沙箱中使用 openpyxl 构建
.xlsx工作簿,写入公式、创建图表并设置格式。图表引用计算单元格,而非静态图片;执行质检,检查表间勾稽关系,例如净利润计入留存收益、现金变动与货币资金一致;无法获取的数据在
Data_Sources表中注明原因;将成品写入
output/目录并登记为产物。调用方下载后,可使用 Excel 或 WPS 继续编辑。
| 层 | 职责 | 数据范围 |
|---|---|---|
| 智能体(kimi-k3) | 执行建模工作流:取数、规范化、预测、估值和质检 | 插件数据源、用户上传的财报文件 |
| 机构金融插件 | 提供建模方法和数据源路由 | Wind、同花顺 iFinD、S&P 等数据源 |
| 云沙箱 | 使用 openpyxl 构建 Excel 文件 | 会话文件系统,产物写入 output/ |
建模流程具有严格的先后顺序,数据获取完成后才能进入预测和估值,因此采用单智能体,以减少多智能体协调成本。插件负责提供建模方法和数据源接入,智能体按照固定流程执行建模任务。
核心设计
官方金融财务建模智能体由模型、系统提示词、机构金融插件和默认内置工具集组成,设计重点包括以下三方面:
可编辑的 Excel 产出:公式可追踪,图表引用计算单元格,假设集中管理且可修改,而不是静态截图;
关键输入可溯源:标注数据源和取数日期,无法获取的数据在
Data_Sources表中注明原因,严禁编造,缺失数据不得按零处理;固定的执行顺序:按照取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检的顺序执行,不得跳步。
以下介绍各项配置的作用,以及自建时的选择。
系统提示词:固定建模工作流
建模中的常见问题包括执行顺序错误、假设依据不足和来源缺失。系统提示词通过明确工作流顺序和数据规范,减少这些问题:
固定流程:收到建模请求后,严格按照「取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检」的顺序执行,不得跳步;数据获取完成后才能开始建模;
数据规范:所有数据均通过插件的数据源路由获取,每个关键输入标注来源和取数日期;无法获取的数据在
Data_Sources表中注明原因,严禁编造;缺失数据不得按零处理,除非明确声明相应假设;假设管理:WACC、永续增长率、预测期收入增速等假设集中记录在 Excel 的 Assumptions 工作表中,模型公式引用对应单元格,修改假设后全模型联动重算;
任务边界:仅用于财务建模,不执行任何交易,不提供投资建议;事实、计算和推断分别呈现;
输出规则:成品写入
output/目录,最终回复使用相对路径列出文件(如output/CATL_model.xlsx),客户端按约定取回。
插件:提供建模方法和数据源接入
机构金融插件(institutional-finance-kit)提供建模所需的方法和数据源接入,包括两部分:
建模技能:插件中的
institutional-financial-modeling技能定义了三表、DCF 与可比公司估值的完整工作流,包括工作表结构、公式设计和敏感性分析方法,为生成完整的财务模型提供规范;数据源路由:插件统一对接 Wind、同花顺 iFinD、S&P 等数据源。智能体通过「能力名」请求数据(如历史财务、市场一致预期),无需直接处理各供应商的接口差异。
工具:使用默认内置工具集
平台默认内置工具集提供文件读写、代码运行和联网检索能力,可直接使用。构建 Excel 时,通过代码运行工具(ipython)在沙箱中调用 openpyxl。插件已覆盖数据获取需求,通常无需额外接入 MCP 服务;如需接入,参见 接入 MCP。
配置选择
本案例选择 kimi-k3。建模需要同时处理长财报原文、技能规范和大量结构化计算,对长上下文和指令遵循能力要求较高;多轮搭建过程中上下文持续增长,kimi-k3 的长上下文能力和缓存计价有助于控制成本,详见下文「运行成本」。
各项资源的配置如下:
| 资源 | 用途 | 本案例的选择 |
|---|---|---|
| 智能体 | 执行建模工作流 | 单智能体,kimi-k3 |
| 插件 | 建模方法 + 数据源路由 | 机构金融插件(institutional-finance-kit) |
| 技能 | 财务建模工作流 | 插件中的 institutional-financial-modeling 技能,随插件挂载 |
| 执行环境 | 构建 Excel 与图表 | 云沙箱,config 声明 openpyxl、numpy、matplotlib 等 pip 依赖 |
| 文件 | 财报、券商研报、内部研究等原始材料(建议尽可能提供) | 上传后以只读副本挂载到会话 |
| 凭据库 | 数据源授权(可选) | 将凭据保存在凭据库,创建会话时添加到 resources |
| 触发器 | 当前不需要 | 按需执行建模任务,无需设置触发器 |
| 记忆库 | 当前不需要 | 每次建模使用独立会话,不依赖跨会话记忆 |
运行成本
在不计插件调用费用的情况下,建模成本主要来自模型 tokens。沙箱按运行时长计费,价格为 ¥0.072 / 小时;一次建模约需 45–90 分钟,费用约 ¥0.1。文件上传与抽取限时免费,详见 托管智能体定价。按 kimi-k3 的 公开单价估算,一次完整建模约需 ¥30–50,耗时 45–90 分钟。
上述估算基于 2026 年 9 月底至 10 月初的若干次生产会话,仅供参考,实际费用以控制台账单为准。费用和耗时会随标的数据量、财报篇幅、上传材料情况以及取数和返工轮次显著变化。数据完整的大型公司与数据较少的新上市标的之间,成本可能相差数倍。上传券商研报、内部研究等材料有助于提高历史数据口径的准确性并减少取数轮次,因此也可能降低成本、缩短耗时(见下文「第 3 步:准备原始材料」)。
一次完整建模需要多轮模型调用,每轮都会携带累积的上下文,累计输入可达上千万 tokens,其中约 95% 为重复前缀。命中上下文缓存后,这部分输入按缓存命中价计费,是控制成本的关键;如果同等输入量全部按未命中价计费,成本约为当前的六至七倍。输出主要为 openpyxl 构建代码和最终回复。插件调用按次数另行计费,不同插件分档定价,详见 托管智能体定价;上述估算不含插件费用。
建模质量在很大程度上取决于输入材料。平台无法直接提供受版权和合规限制的券商研报、私有数据、内部研究和历史财务原文,需要你自行准备并上传,或接入私有信息源(见下文「第 3 步」)。充分的材料有助于提高历史数据口径的准确性、为假设提供依据并减少取数轮次。
从最小版本开始搭建
最小配置为「单智能体 + 机构金融插件」。插件已包含建模技能和数据源接入,完成配置后即可运行。具体步骤如下:
第 1 步:创建智能体
以下是一个可运行的创建命令。该示例并非官方配置的逐字拷贝,当前官方配置以 GET /v1/agents 的返回结果为准:
cURL:
curl -X POST https://api.moonshot.cn/v1/agents \
  -H "Authorization: Bearer $KIMI_API_KEY" \
  -H "kimi-api-version: 2026-09-01-beta" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "我的财务建模助手",
    "model": {"id": "kimi-k3"},
    "system": "你是一个金融财务建模智能体,职责是把一家公司变成一份可编辑的 Excel 财务模型。\n- 严格按流程执行:取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检,取数未完成不得开始搭模型。\n- 所有数据通过插件的数据源路由获取,每个关键输入标注来源与取数日期;取不到的数据在 Data_Sources 表注明原因,严禁编造。\n- 缺失数据不当作零,除非显式声明假设。\n- 所有假设(WACC、永续增长率、收入增速等)集中放在 Excel 的 Assumptions 工作表,模型公式引用假设单元格,改假设可联动重算。\n- 产出包含:三表、DCF(含敏感性分析)、Peer Comps、Football Field 估值区间图,图表引用计算单元格,不用图片贴片。\n- 只做财务建模,不执行任何交易,不出投资建议;事实、计算、推断分开呈现。\n- 成品写入 output/ 目录,最终回复用相对路径逐一列出。",
    "plugins": [
      {"plugin_id": "<机构金融插件 ID>"}
    ],
    "description": "自建财务建模智能体:输入 ticker,产出可编辑 Excel 三表 + DCF 模型"
}'CLI:
kha agents create --file - <<'JSON'
{
    "name": "我的财务建模助手",
    "model": {"id": "kimi-k3"},
    "system": "你是一个金融财务建模智能体,职责是把一家公司变成一份可编辑的 Excel 财务模型。\n- 严格按流程执行:取数 → 报表规范化 → 盈利预测 → 估值建模 → 质检,取数未完成不得开始搭模型。\n- 所有数据通过插件的数据源路由获取,每个关键输入标注来源与取数日期;取不到的数据在 Data_Sources 表注明原因,严禁编造。\n- 缺失数据不当作零,除非显式声明假设。\n- 所有假设(WACC、永续增长率、收入增速等)集中放在 Excel 的 Assumptions 工作表,模型公式引用假设单元格,改假设可联动重算。\n- 产出包含:三表、DCF(含敏感性分析)、Peer Comps、Football Field 估值区间图,图表引用计算单元格,不用图片贴片。\n- 只做财务建模,不执行任何交易,不出投资建议;事实、计算、推断分开呈现。\n- 成品写入 output/ 目录,最终回复用相对路径逐一列出。",
    "plugins": [
      {"plugin_id": "<机构金融插件 ID>"}
    ],
    "description": "自建财务建模智能体:输入 ticker,产出可编辑 Excel 三表 + DCF 模型"
  }
JSON创建成功后,从响应中保存 id 作为 AGENT_ID。通过 GET /v1/plugins 查询插件 ID,并按显示名「机构金融插件」查找,或在控制台智能体表单中直接勾选。可根据需求调整以下字段:
| 字段 | 调整频率 | 配置建议 |
|---|---|---|
system | 经常调整 | 固定市场范围(A 股/港股/美股)、会计准则、默认假设口径、产出模板 |
plugins | 按领域调整 | 替换为其他领域的工作流插件,或增加数据类插件 |
model | 通常保持默认 | kimi-k3 已适配长文档分析与结构化产出 |
| 工具集 | 通常保持默认 | 默认内置工具集即可满足需求,无需额外声明 |
第 2 步:创建执行环境
建模需要 openpyxl、numpy、matplotlib 等 Python 库来构建 Excel 和图表。创建云沙箱环境时,在 config 中声明 pip 依赖;如果数据源通过内网网关访问,请将对应域名加入网络白名单,详见 执行环境。从响应中保存 id 作为 ENVIRONMENT_ID。
第 3 步:准备原始材料(建议尽可能提供)
建议尽可能提供券商研报、私有数据、内部研究和历史财务原文等材料。与仅依靠插件检索相比,使用原始材料有助于提高历史数据口径的准确性和假设的可靠性。提供方式有两种:
第 4 步:创建会话并提交任务
快速开始 已介绍完整调用流程,此处仅展示建模任务的特有部分。创建会话:
cURL:
curl -X POST https://api.moonshot.cn/v1/sessions \
  -H "Authorization: Bearer $KIMI_API_KEY" \
  -H "kimi-api-version: 2026-09-01-beta" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "'"$AGENT_ID"'",
    "environment_id": "'"$ENVIRONMENT_ID"'",
    "title": "宁德时代 DCF 模型"
}'CLI:
kha sessions create --agent "$AGENT_ID" --environment "$ENVIRONMENT_ID" --title "宁德时代 DCF 模型"从响应中保存会话 id 作为 SESSION_ID,订阅事件流(见 快速开始),然后提交任务:
cURL:
curl -X POST https://api.moonshot.cn/v1/sessions/$SESSION_ID/events \
  -H "Authorization: Bearer $KIMI_API_KEY" \
  -H "kimi-api-version: 2026-09-01-beta" \
  -H "Content-Type: application/json" \
  -d '{
    "events": [
      {
        "type": "user.message",
        "data": {
          "content": [
            {"type": "text", "text": "帮我搭建宁德时代(300750.SZ)的 DCF 模型:规范化最近三年三张表,预测未来三年,给出 DCF 估值(含敏感性分析)、可比公司分析和 Football Field 估值区间图。所有数据标注来源与取数日期,假设集中在 Assumptions 表,产出可编辑的 .xlsx。"}
          ]
        }
      }
    ]
}'CLI:
kha sessions send "$SESSION_ID" "帮我搭建宁德时代(300750.SZ)的 DCF 模型:规范化最近三年三张表,预测未来三年,给出 DCF 估值(含敏感性分析)、可比公司分析和 Football Field 估值区间图。所有数据标注来源与取数日期,假设集中在 Assumptions 表,产出可编辑的 .xlsx。"任务描述会直接影响产出质量。编写任务时,建议遵循以下原则:
提供证券代码。 先明确市场(A 股 / 港股 / 美股)和标的,并提供证券代码以避免同名歧义。例如,使用「宁德时代(300750.SZ)」,而不是「帮我看看宁德」。
明确模型范围。 默认产出包括三表、DCF、Peer Comps 和 Football Field;如果只需要部分内容,请明确说明,例如「只要三表和 DCF,不要可比公司」。如需情景分析(乐观 / 中性 / 悲观),也应在任务中注明。
提供已有假设和原始材料。 如有既定假设(例如公司指引中的收入增速、投资委员会确定的 WACC 区间),请直接写入任务,智能体会将其填入 Assumptions 表,而非使用默认值。也应尽可能提供财报原文、券商研报和内部研究(见上文「第 3 步」),以提高历史数据口径的准确性和假设的可靠性。
第 5 步:取回产物
会话状态变为 idle 后,先列出该会话的产物,找到 Excel 文件对应的产物 id:
cURL:
curl "https://api.moonshot.cn/v1/artifacts?session_id=$SESSION_ID" \
  -H "Authorization: Bearer $KIMI_API_KEY" \
-H "kimi-api-version: 2026-09-01-beta"CLI:
kha artifacts list --session "$SESSION_ID"再下载成品:
cURL:
curl "https://api.moonshot.cn/v1/artifacts/$ARTIFACT_ID/content" \
  -H "Authorization: Bearer $KIMI_API_KEY" \
  -H "kimi-api-version: 2026-09-01-beta" \
-o CATL_model.xlsxCLI:
kha artifacts download "$ARTIFACT_ID" --out CATL_model.xlsx如果产物列表为空,或需要查看中间文件,可使用 GET /v1/sessions/$SESSION_ID/filesystem 浏览会话文件系统,详见 文件。
产物为 .xlsx 工作簿,可使用 Excel 或 WPS 打开并编辑,包含以下工作表:
Assumptions:集中记录全部假设,包括 WACC、永续增长率、预测期收入增速和利润率假设。其他工作表的公式引用此表单元格,修改假设后,全模型联动重算;
三表:包括资产负债表、利润表和现金流量表,涵盖历史三年规范化数据、未来三年预测及五年 DCF 延展期;表间勾稽关系包括利润表净利润计入资产负债表留存收益,以及现金流量表现金变动与资产负债表货币资金一致;
DCF:包括自由现金流预测、折现、终值,以及企业价值至股权价值的桥接计算,并附 WACC × 永续增长率的敏感性矩阵;
Peer Comps:同行业可比公司的估值对比表,包含 PE-TTM、PB、前瞻 PE 等指标,数据来自插件的数据源路由;
Football Field:对比不同估值方法(DCF、可比公司、历史区间)的估值范围,图表引用计算单元格,而非静态图片;
Checks:包含资产负债表平衡、现金流与资产负债表衔接、收入衔接等检查,逐期列出差额和 PASS / REFERENCE 状态,便于核对模型是否配平。
假设来源和校准依据记录在 Assumptions 表的「依据 / 来源」列;全部数据均在 Data_Sources 表逐条登记,包括来源、定位、期次、取数时间和使用位置。无法获取的数据也在该表中注明原因。文件保存在会话的 output/ 目录,可通过产物接口下载并继续编辑。
运行监控
取数和建模通常需要 45 分钟至 1.5 小时;需要重试时,耗时可能更长。建议通过事件流持续查看运行状态,直至任务完成。可以通过以下字段判断运行是否正常:
session.status:running表示正在运行,变为idle表示本轮完成,可以下载产物;agent.tool_use:可查看每次数据获取使用的数据源和口径;数据异常时,可优先检查此项;session.error:任务失败时出现,包含错误类型和信息。
订阅事件流的连接可能中途断开,用断开前最后一帧 SSE 消息的 id: 字段作为 cursor 重新订阅即可续读,详见 事件流。
建模场景还需关注以下事项:
| 观察项 | 检查内容 | 排查用途 |
|---|---|---|
agent.tool_use 的取数调用 | 数据源、口径、取数日期 | 历史数据口径异常时,优先检查数据获取是否有误 |
| ipython 执行记录 | openpyxl 构建代码是否报错 | 产物未生成时,检查构建代码是否存在异常 |
| 最终回复的文件清单 | 是否列出了 output/ 下的 .xlsx | 仅列出中间文件,通常表示质检未通过或流程未完整执行 |
可扩展方向
批量建模:为每个标的分别创建会话并并发执行,按会话取回结果,避免相互影响;
嵌入自有系统:将托管智能体 API 集成到自有投研平台,由业务系统创建会话、订阅事件流并取回 Excel,分析师可在自有界面中获取并继续编辑模型;
多智能体拆分:将取数、建模和质检拆分为专职子智能体,并在
multiagent字段中配置委派,详见 多智能体编排。建议先验证单智能体与插件的组合,再评估是否拆分。
相关文档
使用机构金融建模插件:插件的引用方式、版本固定与数据源路由。
上传财报与研究材料:上传财报材料、挂载会话与取回 Excel 产物。
配置 Excel 构建依赖:云沙箱的 pip 依赖声明与网络白名单。